1936 → aujourd’hui : comment l’IA est arrivée dans nos vies
Sept jalons pour comprendre les règles, l’apprentissage et nos choix collectifs.
Ton téléphone traduit un panneau, un logiciel classe des images, un assistant propose une réponse. Le mot « IA » recouvre pourtant des approches différentes. Suivons sept jalons pour comprendre ce qui a changé : écrire des règles, apprendre des réglages, puis rendre ces systèmes utilisables. C'est un parcours choisi, pas une histoire exhaustive.
1936 : formaliser le calcul
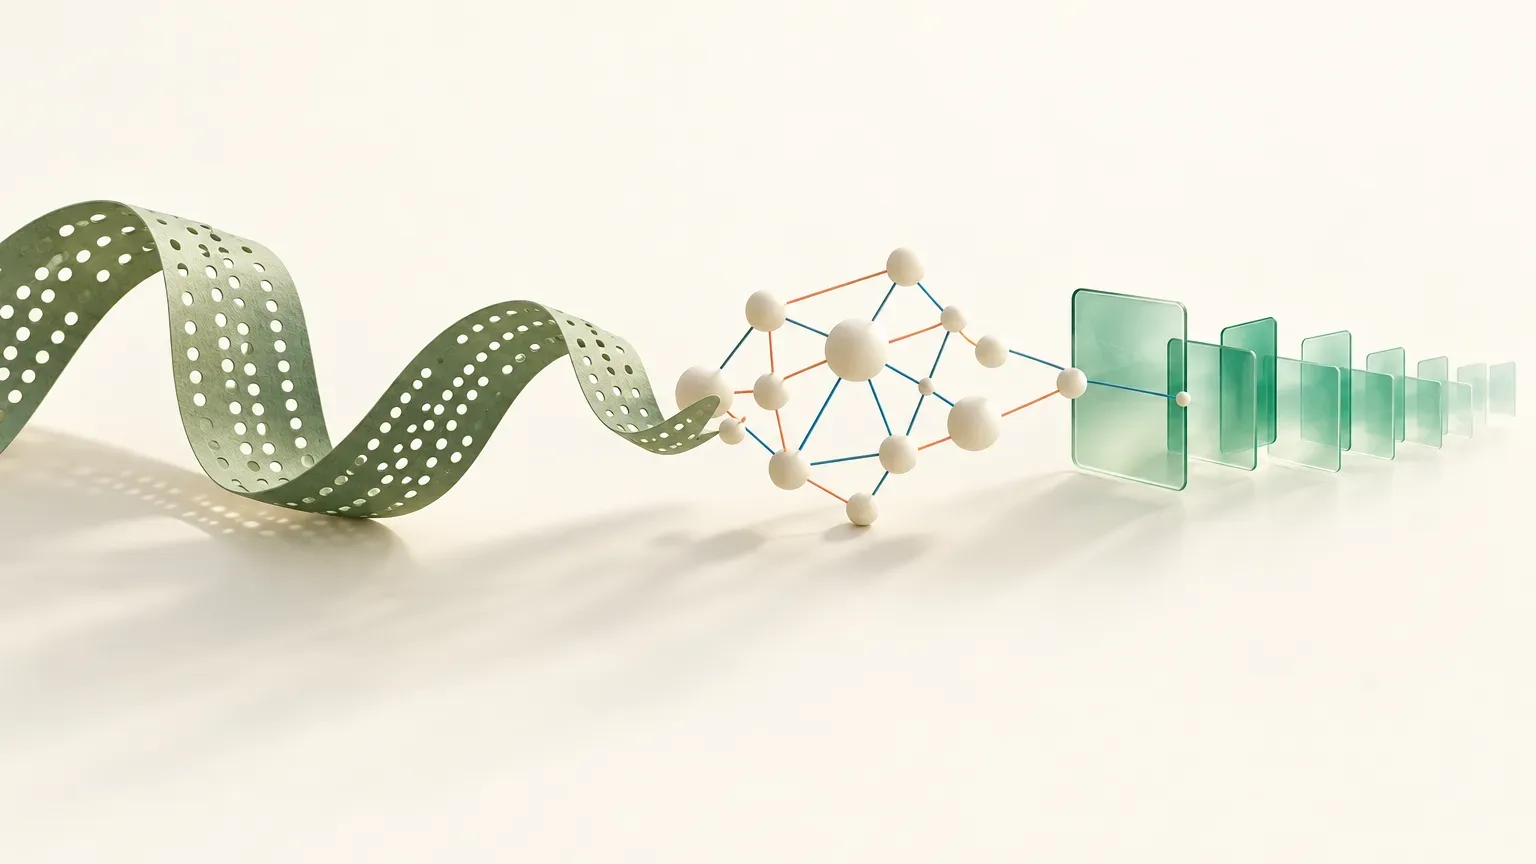
Alan Turing décrit une machine abstraite : un ruban, une tête qui lit et écrit, des règles qui déterminent l'action suivante. Son travail précise ce qu'une procédure de calcul peut accomplir. Il ne présente pas un assistant moderne : il pose des bases de l'informatique.
Notre atelier en montre un exemple très limité. Le nombre 3 s'écrit avec trois symboles « 1 » : c'est une représentation unaire. La tête avance sur les « 1 » ; à la première case vide, elle écrit un « 1 » et s'arrête.
Choisis l'entrée 3, puis Un pas jusqu'à l'arrêt : tu obtiens 4 en quatre pas. Essaie zéro : la première case est vide, donc un pas donne 1. Ici, suivre la règle suffit ; aucun paramètre n'est appris.
Une machine, une règle, une histoire
Fais tourner une petite machine de Turing qui ajoute 1 à un entier écrit en unaire : règle unique, pas à pas, sortie attendue et calculée, une case vide toujours visible. Puis explore sept jalons de l’histoire de l’IA, de Turing en 1936 aux usages diffusés de 2026, chacun avec la question « Qui garde la main ? ».
L'atelier limite les entrées à 0–5. Il illustre une procédure ; il ne simule pas toute la puissance théorique d'une machine universelle.
1956 : nommer un domaine
Le 31 août 1955, McCarthy, Minsky, Rochester et Shannon rédigent une proposition pour un atelier à Dartmouth, prévu l'été 1956. Le terme « intelligence artificielle » y désigne un programme de recherche : faire exécuter par des machines des tâches associées à l'intelligence.
Le nom rassemble des questions, des personnes et des ambitions. Il n'annonce pas une machine déjà capable de tout faire. Les décennies suivantes mêlent plusieurs approches, des réussites ciblées et des limites persistantes.
1986 : entraîner des réseaux à couches
Un réseau de neurones transforme des nombres avec des poids, ses paramètres réglables. L'entraîner consiste à ajuster ces paramètres pour réduire une mesure d'erreur sur des exemples.
L'article de Rumelhart, Hinton et Williams contribue à populariser la rétropropagation : calculer comment les paramètres des différentes couches influencent l'erreur. La méthode possède des antécédents. Ce jalon compte pour sa diffusion, pas comme une invention isolée en une année.
2012 : AlexNet et la reconnaissance d'images
Krizhevsky, Sutskever et Hinton présentent AlexNet, un réseau profond entraîné avec des processeurs graphiques sur plus d'un million d'images étiquetées. Il améliore fortement les résultats sur ImageNet, un ensemble utilisé pour comparer les méthodes de classification d'images.
Données, réseaux et calcul existaient déjà. Ce résultat montre l'intérêt de leur combinaison à cette échelle et renforce l'attention portée à l'apprentissage profond : des réseaux comprenant plusieurs couches de transformation.
2017 : le Transformer
Vaswani et ses collègues proposent le Transformer, notamment pour la traduction. Son architecture utilise l'attention, un mécanisme qui combine des informations de la séquence selon leur pertinence calculée.
L'attention existait auparavant. Le Transformer réorganise ces calculs et permet d'en paralléliser une partie pendant l'entraînement. Ses variantes deviennent une base de nombreux modèles de langage.
2020 : GPT-3 et les exemples dans le contexte
Brown et ses collègues décrivent GPT-3, un grand modèle de langage préentraîné. Il peut réaliser différentes tâches à partir de consignes et de quelques exemples inclus dans le texte fourni, sans modifier ses poids pour chaque tâche.
Cela distingue deux moments : l'entraînement ajuste le modèle ; l'utilisation exploite les réglages acquis et le contexte présent. Les assistants ajoutent ensuite une interface, des adaptations aux instructions et parfois des outils autour de ce calcul.
2026 : une diffusion inégale
Le rapport AI Index 2026 de Stanford HAI documente une adoption rapide, dont le rythme varie selon les pays et leur niveau de revenu. L'accès aux usages et la maîtrise des infrastructures restent des questions collectives.
Pour IA pour tous, comprendre ces outils aide à choisir leur place. La frugalité consiste à rechercher des moyens proportionnés au besoin. La souveraineté concerne la maîtrise de ses outils, de ses données et de ses dépendances. Ces objectifs demandent des choix concrets, au-delà de la performance d'un modèle.
Garder la main
Trois questions peuvent guider ton prochain usage : une règle simple suffirait-elle ? Où vont les données que tu fournis ? Pourras-tu continuer à utiliser l'outil avec tes moyens, ou en changer ?
Commence le parcours en trois parties avec D'où vient le neurone artificiel ?. Pour le langage, découvre comment un LLM fabrique une réponse.
Sources
Les travaux originaux sont liés près de chaque jalon : Turing (1936), proposition de Dartmouth (1955), Rumelhart et collègues (1986), AlexNet (2012), Transformer (2017), GPT-3 (2020) et Stanford HAI (2026).